Cloud SQL을 서울 리전에서 운영하는 고객이 다른 리전에 재해 복구(DR) 환경을 두려면 어떻게 구성해야 하는지 문의한 적이 있다. 후보로 자카르타와 더 멀리 떨어진 리전이 거론됐다. 당시 작성한 자료에는 서울 리전의 HA와 타 리전의 읽기 복제본을 함께 사용한다는 기본 구성이 담겨 있다. 이 글에서는 그 구성이 각각 어떤 장애를 처리하는지, DR 리전을 고를 때 무엇을 확인해야 하는지 정리한다.
아래 구성은 고객 환경에서 장애 전환을 실행한 결과가 아니라, 해당 문의를 바탕으로 정리한 설계 예시다. 데이터베이스 엔진별 세부 동작은 다를 수 있으므로, 장애 전환 절차는 이 글에서 주로 참고한 Cloud SQL for PostgreSQL의 공식 문서를 기준으로 설명한다.
HA와 DR은 대응하는 장애 범위가 다르다#
서울 리전에서 Cloud SQL 인스턴스의 **고가용성(HA)**을 활성화하면 같은 리전의 서로 다른 존에 기본 인스턴스와 대기 인스턴스를 둔다. 존 장애 등에 대한 자동 장애 조치가 목적이다. 연결 주소도 유지된다. 하지만 서울 리전 전체가 사용할 수 없게 되면, 같은 리전의 대기 인스턴스만으로 서비스를 이어갈 수 없다. Cloud SQL HA 문서
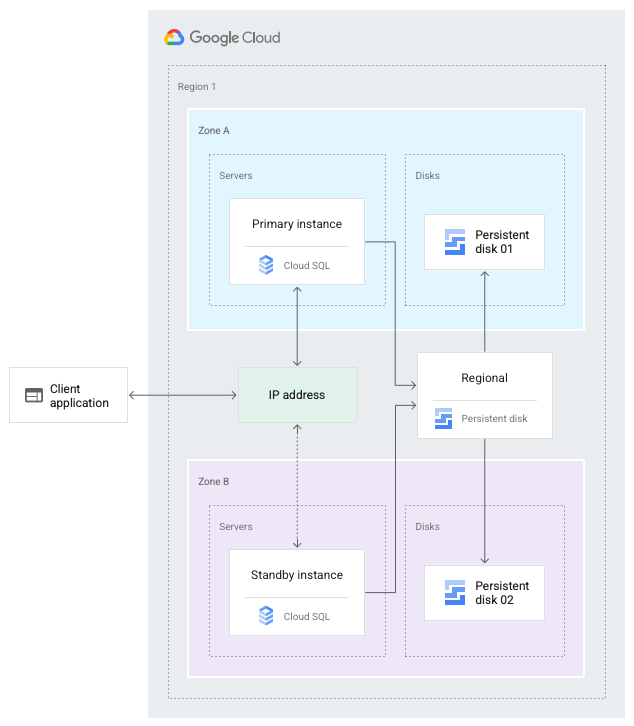
당시 기술지원 자료에 넣었던 Google Cloud HA 구성도. 두 존 모두 같은 리전에 있다.
리전 장애까지 대비하려면 다른 리전에 리전 간 읽기 복제본을 둔다. 서울에서 자카르타(asia-southeast2) 같은 다른 리전으로 데이터가 비동기 복제된다. 주 리전 장애 시 운영자가 복제본을 승격하고 애플리케이션 연결을 새 기본 인스턴스로 전환하는 구성이다. 일반적인 읽기 복제본의 승격은 HA의 자동 장애 조치와 다르다. 리전 간 복제본 승격 문서
| 구성 | 대비하는 장애 | 장애 시 동작 |
|---|---|---|
| 서울 리전 HA | 서울의 존 또는 인스턴스 장애 | Cloud SQL의 HA 장애 조치 |
| 자카르타 등 다른 리전의 읽기 복제본 | 서울 리전 장애 | 복제본 승격과 애플리케이션 연결 변경 필요 |
| 백업 | 삭제·오염·복구 시점 선택 등 | 백업에서 복원; 복제본과 역할이 다름 |
서울과 자카르타에 배치한다면#
예시 구성은 다음과 같다.
서울과 자카르타 모두 Cloud SQL for PostgreSQL을 제공한다. 다만 사용할 에디션·머신 유형·데이터베이스 버전은 실제 인스턴스 생성 전에 다시 확인해야 한다. 리전별 제공 현황
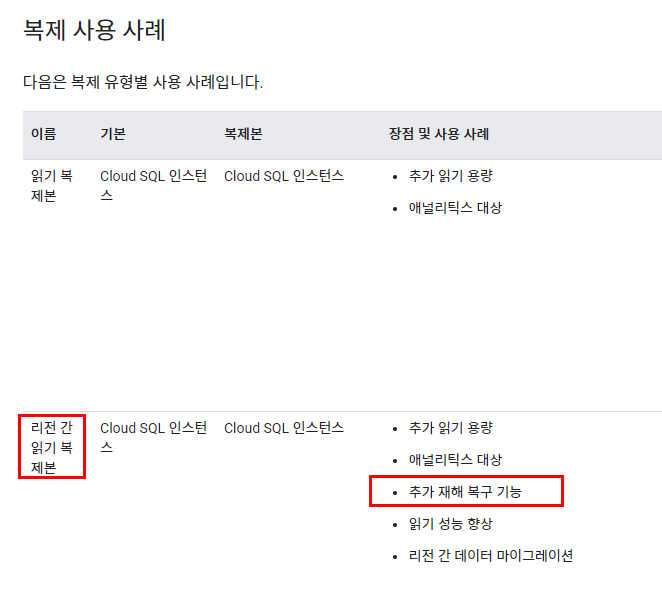
당시 자료에서 리전 간 읽기 복제본의 재해 복구 용도를 확인한 화면. Google Cloud는 기능을 업데이트하면서 UI와 문서 화면 구성도 조금씩 바꾸므로, 현재 보이는 메뉴나 화면은 다를 수 있다. 최신 절차는 위 공식 문서에서 확인한다.
운영 환경에서는 서울의 기본 인스턴스에 HA를 설정하고, 자카르타에는 리전 간 읽기 복제본을 만든다. 자카르타 복제본 자체에도 HA가 필요한지는 서울 장애 이후 자카르타의 존 장애까지 감당해야 하는지에 따라 결정한다. DR 리전의 복제본을 만든 것만으로 애플리케이션이 자동 전환되지는 않는다.
데이터 손실 가능성: 리전 간 복제는 비동기다. 서울에서 처리한 최신 트랜잭션이 자카르타에 아직 반영되지 않았을 수 있다. 장애 시점의 실제 복제 지연이 복구 가능한 데이터 시점(RPO)에 영향을 준다. Cloud SQL DR 개요, 복제 지연 모니터링
DR 리전을 멀리 둘수록 더 안전할까?#
자카르타 대신 지리적으로 훨씬 먼 리전을 선택하는 이유는 서울과 재해 영향권을 더 분리하려는 것일 수 있다. 그러나 거리만으로 적절한 DR 리전을 결정할 수는 없다. 원거리 복제는 네트워크 지연이 커질 수 있고, 쓰기 부하나 복제본 성능에 따라 복제 지연도 달라진다. 장애 후 서비스를 원거리에서 계속 제공할 때의 사용자 응답 시간도 확인해야 한다. 복제 지연 원인
| 결정 조건 | 확인할 내용 |
|---|---|
| 데이터 위치 | 고객 데이터가 국외로 복제되어도 되는가? 계약·규제·내부 정책을 확인한다. |
| 목표 복구 시점(RPO) | 평상시와 쓰기 부하가 큰 시간대의 실제 복제 지연을 측정한다. |
| 목표 복구 시간(RTO) | 복제본 승격, 애플리케이션 연결 변경, 서비스 확인에 걸리는 시간을 측정한다. |
| 장애 후 서비스 위치 | DB만 옮길지, 애플리케이션도 DR 리전에서 실행할지 결정한다. |
| 비용 | DR 복제본 인스턴스·스토리지, 리전 간 복제 트래픽, DR 리전의 앱 자원을 함께 산정한다. |
특히 애플리케이션은 서울에 둔 채 DB만 먼 리전으로 옮기면, 서울 리전 장애 시 애플리케이션도 멈출 수 있다. DR 설계에는 DB 승격뿐 아니라 앱 실행 위치, 네트워크 경로, 접속 정보 전환을 포함해야 한다. 자카르타와 더 먼 리전 중 어느 쪽이 나은지는 이 조건을 정한 뒤 비교하는 편이 정확하다.
예를 들어 한국 사용자에게 서비스를 제공하고, 국외 데이터 복제가 허용되는 서비스를 가정해보자. 이 경우에는 자카르타를 먼저 후보로 두고 평상시 복제 지연, 복제본 승격부터 서비스 재개까지 걸리는 시간, 장애 후 앱·DB 응답 시간을 시험할 수 있다. 요구한 RPO와 RTO를 만족한다면, 단순히 서울에서 더 멀리 떨어져 있다는 이유만으로 DR 리전을 바꿀 근거는 부족하다.
반대로 서울과 가까운 지역까지 영향을 줄 수 있는 재해를 설계 조건으로 삼았다면 더 먼 리전도 후보가 된다. 이때는 원거리 복제 지연, 장애 후 한국 사용자 응답 시간, DR 리전에서 앱을 실행하는 비용을 같은 워크로드로 확인해야 한다. 어느 리전이 목표를 만족하는지는 여기서 측정한 값 없이 단정할 수 없다. 국외 복제가 허용되지 않는다면 자카르타와 원거리 해외 리전 모두 후보에서 제외하고, 데이터 위치 조건에 맞는 복구 방식을 다시 설계해야 한다.
서울 리전 장애 시 전환 순서#
- 장애 범위를 확인하고 서울의 쓰기 요청을 중지하거나 차단한다. 서울이 복구됐을 때 두 기본 인스턴스에 동시에 쓰지 않도록 전환 책임자를 정한다.
- DR 복제본의 마지막 반영 시점과 복제 지연을 확인하고, 허용 가능한 데이터 손실 범위와 비교한다.
- DR 복제본을 기본 인스턴스로 승격한다. 일반적인 읽기 복제본 승격은 운영자가 결정해 실행한다.
- 애플리케이션의 DB 접속 대상과 필요한 인증·네트워크 설정을 새 기본 인스턴스로 변경한다.
- 읽기·쓰기와 주요 기능을 확인한 뒤 서비스를 재개한다. 새 기본 인스턴스의 HA와 다음 DR 복제본도 구성한다.
서울이 복구되었다고 기존 인스턴스를 곧바로 다시 쓰기 대상으로 사용하면 안 된다. 자카르타에서 처리한 데이터와 서울의 기존 데이터가 달라졌을 수 있기 때문이다. 서울로 되돌아가는 절차까지 별도로 설계해야 한다. Cloud SQL DR 개요
현재 Cloud SQL Enterprise Plus에는 지정된 DR 복제본을 사용하는 Advanced DR 기능도 있다. 당시 자료의 일반 읽기 복제본 승격 방식과 동작이 다르므로, 이 기능을 사용할 계획이라면 에디션 지원 여부와 장애 전환·되돌리기 절차를 별도 문서에서 확인해야 한다.
결론은 리전 거리보다 허용 가능한 데이터 손실과 복구 시간을 먼저 정하는 것이다. 서울 HA는 존 장애 대응, 타 리전 복제본은 리전 장애 대응이라는 역할이 분명하다. 자카르타든 더 먼 리전이든 복제 지연을 측정하고, DB 승격부터 애플리케이션 재접속과 서울 복귀까지 한 번의 절차로 시험해야 실제 DR 구성이 된다.