IBM MQ, TIBCO EMS, Apache ActiveMQ 같은 전통적인 MOM(Message-Oriented Middleware)의 큐를 사용했다면, 메시지를 수신하고 ACK 또는 트랜잭션 commit으로 처리를 확정하는 방식에 익숙할 것이다. 제품과 소비 모드에 따라 구체적인 동작은 다르다. TIBCO EMS 메시징 모델, ActiveMQ Classic 소개
Kafka에서는 메시지를 읽고 offset을 commit해도 토픽의 데이터가 제거되지 않는다. 그렇다면 offset은 무엇이고, 무엇을 commit하는 것일까?
IBM MQ의 일반 큐에서 트랜잭션으로 메시지를 가져오는 방식과 Kafka의 일반 소비자 그룹을 비교한다. Kafka 캡처는 Kafbat UI 실습에서 확인한 결과이며, IBM MQ와 장애 상황 예시는 공식 동작을 설명하기 위한 것이다. 별도의 IBM MQ 실행이나 장애 테스트를 수행한 결과는 아니다.
1. IBM MQ: 가져온 메시지의 제거를 확정한다#
IBM MQ에서는 메시지를 트랜잭션 안에서 가져온 뒤, 처리 성공 시 commit, 실패 시 rollback하는 흐름을 구성할 수 있다.
사용하는 API에 따라 호출 이름은 다르다. **JMS의 로컬 트랜잭션 세션에서는 Session.commit() / Session.rollback()**을 사용한다. 네이티브 MQI에서는 MQCMIT / MQBACK을 사용하며, rollback에 해당하는 동작을 backout이라고 부른다. 이 글에서는 트랜잭션 취소를 rollback으로 표현한다. IBM MQ JMS 트랜잭션, IBM MQ MQBACK
아래는 네이티브 MQI의 MQGMO_SYNCPOINT 옵션으로 MQGET을 호출하는 예시다.
큐: 주문 A, 주문 B, 주문 C

MQGET으로 주문 A 가져오기 → 주문 A 처리
  성공: commit   (MQCMIT) → 주문 A의 큐 제거 확정
  실패: rollback (MQBACK) → 주문 A를 다시 가져올 수 있게 복원
메시지를 가져온 뒤 commit하기 전에는 다른 프로그램이 그 메시지를 가져갈 수 없다. commit하면 해당 큐에서 제거되고, rollback하면 다시 가져올 수 있다. 여기서는 트랜잭션 대상 메시지를 가져오는 경우를 설명하며, Browse와는 다르다. IBM MQ 트랜잭션 확정과 취소
commit한 주문 A를 같은 큐에서 다시 가져오는 기능은 아니다. 재처리에 필요한 원본은 별도로 저장하거나 다른 큐에 보관하는 등의 설계가 필요하다. 큐에서 메시지를 제거한다는 것이 주문 DB의 기록까지 삭제한다는 뜻은 아니다.
2. Kafka: 메시지 위치와 소비자의 재개 위치를 구분한다#
Kafka 토픽은 하나 이상의 파티션으로 나뉘며, 레코드가 저장될 때 각 파티션 안에서 위치를 나타내는 offset을 부여받는다.
새 파티션에 주문 이벤트 3개를 발행한 예시는 다음과 같다.
| 토픽 | 파티션 | 메시지 offset | 주문 번호 |
|---|---|---|---|
orders-demo | 0 | 0 | demo-001 |
orders-demo | 0 | 1 | demo-002 |
orders-demo | 0 | 2 | demo-003 |
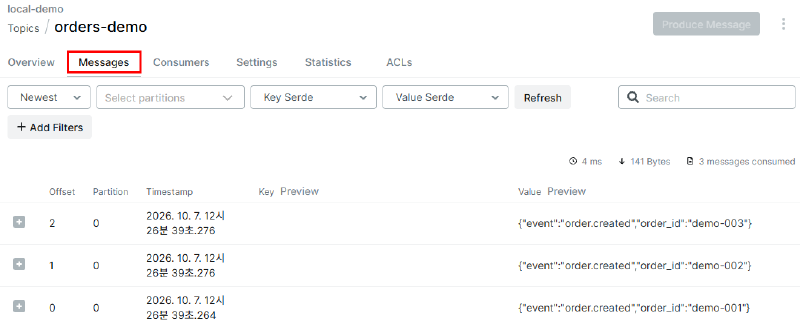
캡처는 최신순으로 표시돼 있지만, 각 주문 이벤트의 offset은 표와 같다. offset은 주문 번호나 토픽 전체의 공통 번호가 아니다. 다른 파티션에도 offset 0인 메시지가 있을 수 있다. 삭제·compaction 등으로 중간 번호가 빠질 수도 있으므로 offset을 메시지 개수와 동일하게 취급하면 안 된다. Kafka 파티션과 offset
메시지 offset과 committed offset#
0·1·2를 모두 처리한 그룹은 다음에 읽을 위치인 3을 commit한다.
파티션에 저장된 메시지: [0: 주문 A] [1: 주문 B] [2: 주문 C]

그룹이 0, 1, 2를 처리하고 offset 3을 commit
  → 메시지 0, 1, 2는 토픽에 남음
  → 재시작 시 다음 위치 3부터 읽기 재개
“offset 3을 commit했다”는 마지막으로 처리한 메시지가 3이라는 뜻이 아니다. 이 예시에서는 마지막 메시지의 offset이 2이고, commit한 값은 다음에 읽을 위치인 3이다.
실행 중 소비자의 읽기 위치는 poll()로 레코드를 받으면 진행된다. 그 위치를 commit하지 않았다면 재시작 시 사용할 저장된 위치는 여전히 이전 값일 수 있다. 읽었다는 것, 업무 처리를 끝냈다는 것, offset을 commit했다는 것은 각각 구분해야 한다. Kafka 읽기 위치와 커밋된 위치
3. 같은 commit이라는 말이지만 결과는 다르다#
| 기준 | IBM MQ의 트랜잭션 MQGET | Kafka의 일반 소비자 그룹 |
|---|---|---|
| 소비자가 받는 것 | 큐에서 가져온 메시지 | 파티션에 저장된 레코드 |
| commit 대상 | 트랜잭션 안의 MQGET·MQPUT 작업 | 그룹·파티션별 다음 읽기 위치 |
| 메시지를 가져온 뒤 commit | 해당 큐에서 메시지 제거 확정 | 토픽 데이터는 제거하지 않음 |
| 장애 후 재처리 | 미확정 MQGET 작업이 rollback되면 다시 수신 가능 | 저장된 offset에서 읽기 재개 |
| 완료한 데이터 재조회 | 제거된 메시지는 해당 큐에 없음 | 데이터가 남아 있으면 읽기 위치를 조정해 가능 |
예를 들어 IBM MQ에서 주문 A를 가져온 트랜잭션을 commit하면, A의 제거가 확정된다. Kafka에서 주문 A의 offset이 0이고 다음 위치 1을 commit하면, A는 토픽에 남고 그 그룹의 재개 위치만 1로 저장된다. IBM MQ 트랜잭션 설명, Kafka offset 저장
이 글의 Kafka commit은 consumer offset commit이다. Kafka의 producer transaction을 commit하는 기능과 혼동하면 안 된다.
4. 여러 서비스는 각자의 위치에서 읽는다#
알림 서비스와 매출 집계 서비스가 같은 주문 이벤트를 읽는다고 가정한다. 서로 다른 소비자 그룹을 사용하면 위치를 독립적으로 관리한다.
| 소비자 그룹 | 순서대로 처리 완료한 메시지 offset | commit할 다음 위치 |
|---|---|---|
| 알림 그룹 | 0, 1, 2 | 3 |
| 매출 집계 그룹 | 0 | 1 |
알림 그룹이 3을 commit해도 집계 그룹의 위치가 3으로 바뀌지는 않는다. 집계 그룹은 자신의 위치 1부터 이어서 읽을 수 있다. 같은 그룹 안에서는 파티션을 나눠 소비하고, 서로 다른 그룹은 같은 데이터를 독립적으로 읽는다. Kafka 소비자 그룹
IBM MQ 같은 MOM도 큐·구독을 따로 구성해 여러 서비스에 메시지를 전달할 수 있다. 여러 서비스가 받는다는 것 자체가 Kafka만의 기능은 아니다. 차이는 Kafka에서 같은 보관 데이터를 그룹별 위치로 읽는다는 점이다.
그룹을 바꾸면 처음부터 받을까?#
다른 그룹이 commit한 위치와는 무관하지만, 새 그룹도 자신의 읽기 위치가 필요하다. 메시지의 offset은 그대로이며, 그룹별로 다음에 읽을 위치만 따로 저장한다.
주문 A·B·C가 offset 0·1·2에 남아 있고, 기존 그룹 A가 3을 commit한 상태를 가정한다.
| 그룹 | 시작 기준 | 받는 메시지 |
|---|---|---|
| 기존 그룹 A | 저장된 offset 3 | 새 메시지를 기다림 |
| 처음 사용하는 그룹 B | auto.offset.reset=earliest | 보관된 주문 A·B·C부터 읽음 |
| 처음 사용하는 그룹 C | auto.offset.reset=latest | 시작 위치를 정한 이후 추가되는 메시지부터 읽음 |
auto.offset.reset은 저장된 offset이 없거나, 데이터 삭제 등으로 그 위치가 유효하지 않을 때 시작 위치를 정하는 설정이다. earliest는 현재 보관된 가장 앞 위치이므로 반드시 0은 아니다. latest는 파티션 끝에서 시작하며, Java 소비자의 기본값이다. Kafka 시작 위치 설정
그룹 B가 이전에 사용됐고 유효한 committed offset이 남아 있다면, earliest로 설정해도 저장된 위치에서 이어서 읽는다. 그룹 이름만 바꾼다고 무조건 처음부터 읽는 것은 아니다.
실제 UI에서는 무엇을 확인했나#
Kafbat UI 실습의 ui-demo-a 그룹에서는 다음 값이 표시됐다.
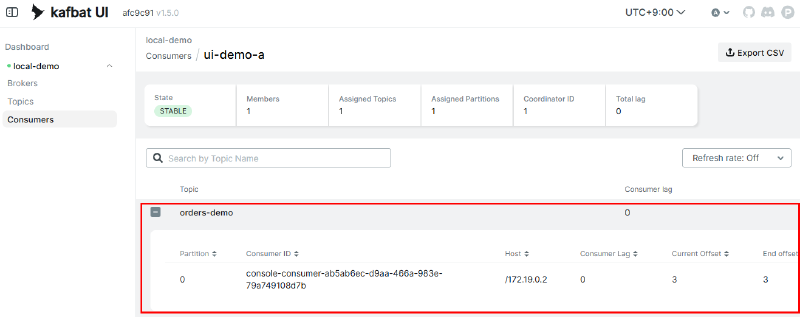
| UI 항목 | 값 | 해석 |
|---|---|---|
| Current Offset | 3 | 그룹이 커밋한 다음 읽기 위치 |
| End offset | 3 | 파티션 끝의 다음 위치 |
| Consumer Lag | 0 | 이번 데이터에서 끝 위치와 커밋된 위치의 차이 |
이 캡처는 콘솔 소비자가 주문 이벤트 3개를 출력하고 offset을 commit한 결과다. 실제 결제나 집계 처리를 수행한 것은 아니다. Lag 0만으로 업무 처리 성공을 판단할 수는 없다.
5. 프로그램이 중단되면 어디서 다시 시작할까#
아래는 파티션 하나를 순서대로 처리하고, 실패 시 Kafka에 저장된 offset에서 재개하는 예시다. 장애를 직접 재현한 결과는 아니다.
처리 후 commit 전에 중단: 중복 가능성#
저장된 offset: 1
offset 1의 주문 B에 대한 메일 발송 완료
다음 위치 2를 commit하기 전에 프로그램 중단

재시작: 저장된 위치 1부터 읽음
결과: 주문 B의 메일이 다시 발송될 수 있음
처리 전에 commit하고 중단: 누락 가능성#
offset 1의 주문 B를 읽고 다음 위치 2를 먼저 commit
주문 B의 메일을 보내기 전에 프로그램 중단

재시작: 저장된 위치 2부터 읽음
결과: 주문 B는 자동 재개 과정에서 건너뛸 수 있음
누락 예시에서도 레코드가 토픽에서 삭제된 것은 아니다. 다만 그룹의 저장된 위치가 이미 진행돼 별도 재처리 없이는 건너뛰게 된다. 처리 완료 후 commit하고, 주문 번호 같은 작업 식별자로 중복 실행을 방지하는 설계가 필요하다. Kafka 처리와 commit 시점
IBM MQ도 메일 발송과 MQ 트랜잭션이 별개라면, 발송 후 메시지를 가져온 트랜잭션을 rollback할 때 같은 메일을 다시 보낼 수 있다. 트랜잭션을 사용한다고 그 범위 밖의 외부 작업까지 자동으로 되돌아가는 것은 아니다. MQ와 DB를 함께 확정하려면 별도의 트랜잭션 연동 구성이 필요하다. IBM MQ 트랜잭션 범위와 조정
6. IBM MQ Browse와 Kafka replay는 다르다#
IBM MQ의 Browse는 큐에 남아 있는 메시지를 제거하지 않고 조회하는 기능이다. MQGMO_BROWSE_FIRST, MQGMO_BROWSE_NEXT 등으로 browse cursor를 이동한다. 일반 MQGET 후 commit으로 제거한 메시지를 되살려 조회하는 기능은 아니다. IBM MQ browse cursor
Kafka replay는 보관된 레코드를 이전 위치부터 다시 읽는 것이다. 같은 그룹에서 읽기 위치를 조정하거나, 새 그룹으로 보관된 처음 위치부터 읽을 수 있다. 이는 업무 처리를 취소하는 rollback이 아니라 데이터를 다시 입력받는 동작이다. 외부 처리 결과는 재조회만으로 되돌아가지 않는다.
commit한 위치가 3이어도 이전 메시지를 받을 수 있다#
주문 A·B·C가 아직 남아 있다면, 다음과 같이 해당 파티션의 읽기 시작 위치를 변경할 수 있다.
| 변경할 읽기 위치 | 다시 받는 메시지 |
|---|---|
0 | 주문 A·B·C |
1 | 주문 B·C |
2 | 주문 C |
3 | 기존 세 건은 읽지 않고 새 메시지를 기다림 |
이때 메시지에 부여된 offset을 수정하는 것이 아니라, 소비자가 읽기 시작할 위치를 바꾸는 것이다. 방법도 구분해야 한다.
seek(): 실행 중 소비자에게 할당된 파티션의 읽기 위치를 변경한다.seek()호출만으로 Kafka에 저장된 committed offset이 변경되지는 않는다. 이후 commit하거나 자동 commit이 수행되면 저장된 위치도 변경될 수 있다. Kafka 읽기 위치 변경- 그룹 offset 재설정: 해당 그룹의 소비자들을 모두 중지하고, 관리 도구로 저장된 재개 위치를 변경한 뒤 다시 실행한다. 다른 그룹의 저장된 위치는 변경되지 않는다. Kafka 그룹 offset 재설정
예를 들어 집계 로직을 수정한 뒤 지난주 주문 이벤트를 다시 읽어 통계를 재계산할 수 있다. 단, 읽기 위치만 바꾼다고 기존 집계 결과가 자동 초기화되는 것은 아니므로, 결과를 덮어쓸지 중복을 제거할지도 정해야 한다.
7. 메시지는 언제 삭제될까?#
Kafka는 소비자가 읽거나 offset을 commit했을 때가 아니라, 토픽의 보관·정리 정책에 따라 데이터를 삭제한다.
cleanup.policy | 정리 기준 |
|---|---|
delete | 보관 기간(retention.ms) 또는 파티션별 용량 제한(retention.bytes)에 따라 오래된 로그 세그먼트를 삭제 |
compact | 같은 key의 최신 값을 남기도록 과거 값을 백그라운드에서 정리 |
compact,delete | compaction과 기간·용량 기준 삭제를 함께 적용 |
예를 들어 delete 정책에서 보관 기간을 7일로 설정하고 용량 제한은 두지 않았다고 가정한다.
- 오늘 읽고 commit한 메시지도, 아직 보관돼 있다면 다시 읽을 수 있다.
- 아무 소비자도 읽지 않은 메시지라도 기간 기준을 충족하면 삭제 대상이 된다.
- 용량 제한까지 설정하면, 데이터가 많이 쌓여 7일보다 먼저 오래된 데이터가 삭제될 수도 있다.
기간 기반 삭제는 메시지마다 정확히 7일 뒤 실행되는 타이머가 아니다. 로그 세그먼트 단위로 삭제하며, 실제 시점은 세그먼트 전환과 정리 주기 등에 따라 달라진다. compaction도 즉시 실행되지 않으므로 같은 key의 여러 값이 잠시 함께 남을 수 있다. Kafka 토픽 보관·정리 정책
이미 삭제된 데이터는 읽기 위치를 옮기거나 새 그룹을 만들어도 복구할 수 없다. 지난주 데이터를 재처리해야 한다면, 그 데이터가 남아 있도록 보관 기간·용량과 compaction 적용 여부를 정해야 한다.
마무리#
offset은 파티션에 저장된 레코드의 위치다. 소비자 그룹이 commit하는 값은 다음에 읽을 위치이며, commit 자체가 토픽 데이터를 삭제하거나 외부 업무 처리를 확정하지는 않는다.
IBM MQ의 트랜잭션 MQGET은 가져온 메시지의 제거를 commit으로 확정한다. Kafka에서는 그룹별로 읽기 위치를 저장하고, 데이터 삭제는 보관 정책이 결정한다. 따라서 commit한 메시지도 남아 있다면 다시 읽을 수 있지만, 그 메시지로 이미 수행한 업무까지 취소되는 것은 아니다.